
FastAPI核心
FastAPI - 响应
内置响应类型
INFO
默认情况下,FastAPI 会自动将路径操作函数返回的Python 对象(字典、列表、Pydantic 模型等),经由 jsonable_encoder 转换为JSON兼容格式,并包装为 JSONResponse 返回。这省去了手动序列化的步骤,让开发者能更专注于业务逻辑。如果需要返回非 JSON 数据(如 HTML、文件流),FastAPI 提供了丰富的响应类型来返回不同数据
| 响应类型 | 用途 | 示例 |
|---|---|---|
| StreamingResponse | 流式响应 | 生成器函数返回数据 |
| JSONResponse | 默认响应,返回JSON数据 | return {"key": "value"} |
| FileResponse | 返回文件下载 | return FileResponse(path) |
| HTMLResponse | 返回HTML内容 | return HTMLResponse(html_content) |
| RedirectResponse | 重定向 | return RedirectResponse(url) |
| PlainTextResponse | 返回纯文本 | return PlainTextResponse("text") |
响应类型设置方式
装饰器中指定响应类
场景:固定返回类型(HTML、纯文本等)
@app.get("/html",response_class=HTMLResponse)
async def get_html():
	return"<h1>这是标题</h1>"
返回响应对象
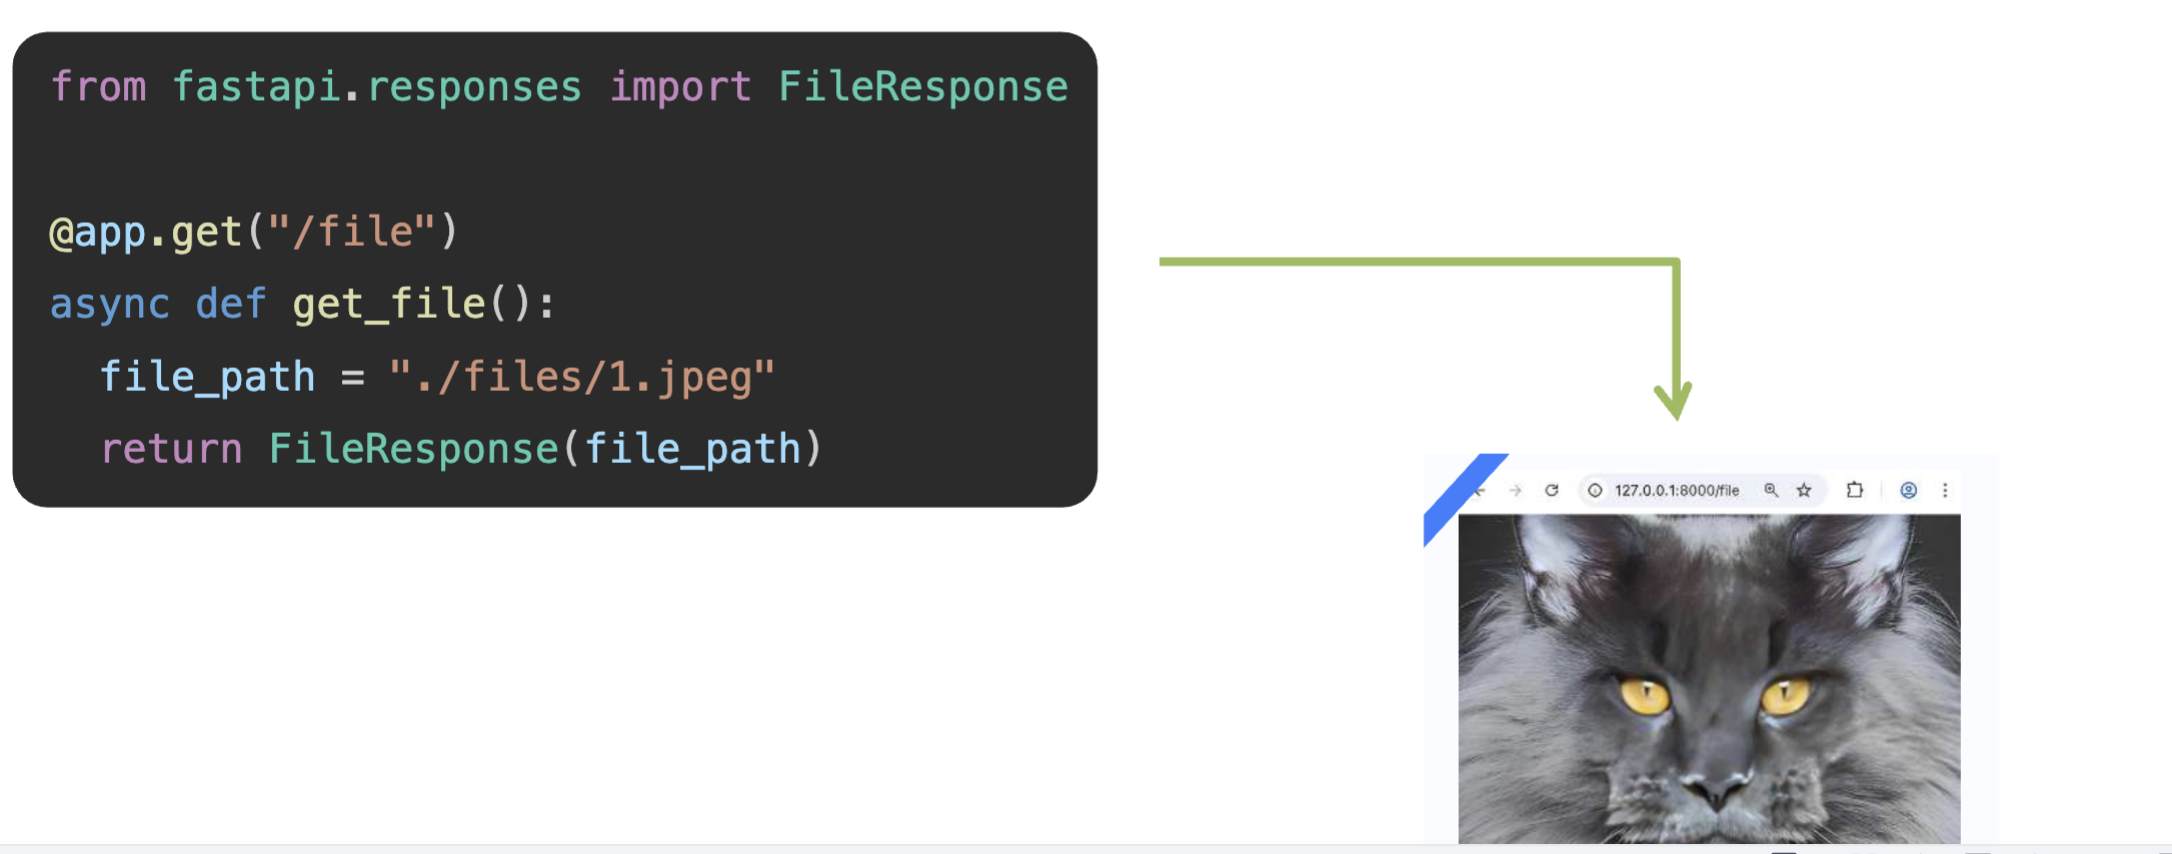
场景:文件下载、图片、流式响应
@app.get("/file")
async def get_file():
	file_path="./files/1.jpeg"
	return FileResponse(file_path)
自定义响应数据格式
response_model是路径操作装饰器(如 @app.get或 @app.post)的关键参数,它通过Pydantic 模型来严格定义和约束 API 端点的输出格式。这一机制在提供自动数据验证和序列化的同时,更是保障数据安全性的第一道防线
示例
from typing import List
from fastapi import FastAPI
from pydantic import BaseModel, Field

# 创建FastAPI应用实例
app = FastAPI()

# 定义学生请求数据模型
class student(BaseModel):
   # 学生ID
   id: int
   # 学生姓名,设置默认值、字段标题和最大长度约束
   name :str = Field(None, title="name of student", max_length=10)
   # 学生成绩列表,默认空列表
   marks: List[int] = []
   # 百分比成绩字段(待后续计算赋值)
   percent_marks: float

# 定义百分比成绩响应数据模型
class percent(BaseModel):
   # 学生ID
   id:int
   # 学生姓名,设置默认值、字段标题和最大长度约束
   name :str = Field(None, title="name of student", max_length=10)
   # 计算后的百分比成绩
   percent_marks: float

# 定义POST请求路由,路径为/marks,指定响应数据模型为percent
@app.post("/marks", response_model=percent)
async def get_percent(s1:student):
   # 计算百分比成绩:成绩列表求和后除以2(保留原逻辑)
   s1.percent_marks=sum(s1.marks)/2
   # 返回计算后的学生数据(符合响应模型格式)
   return s1
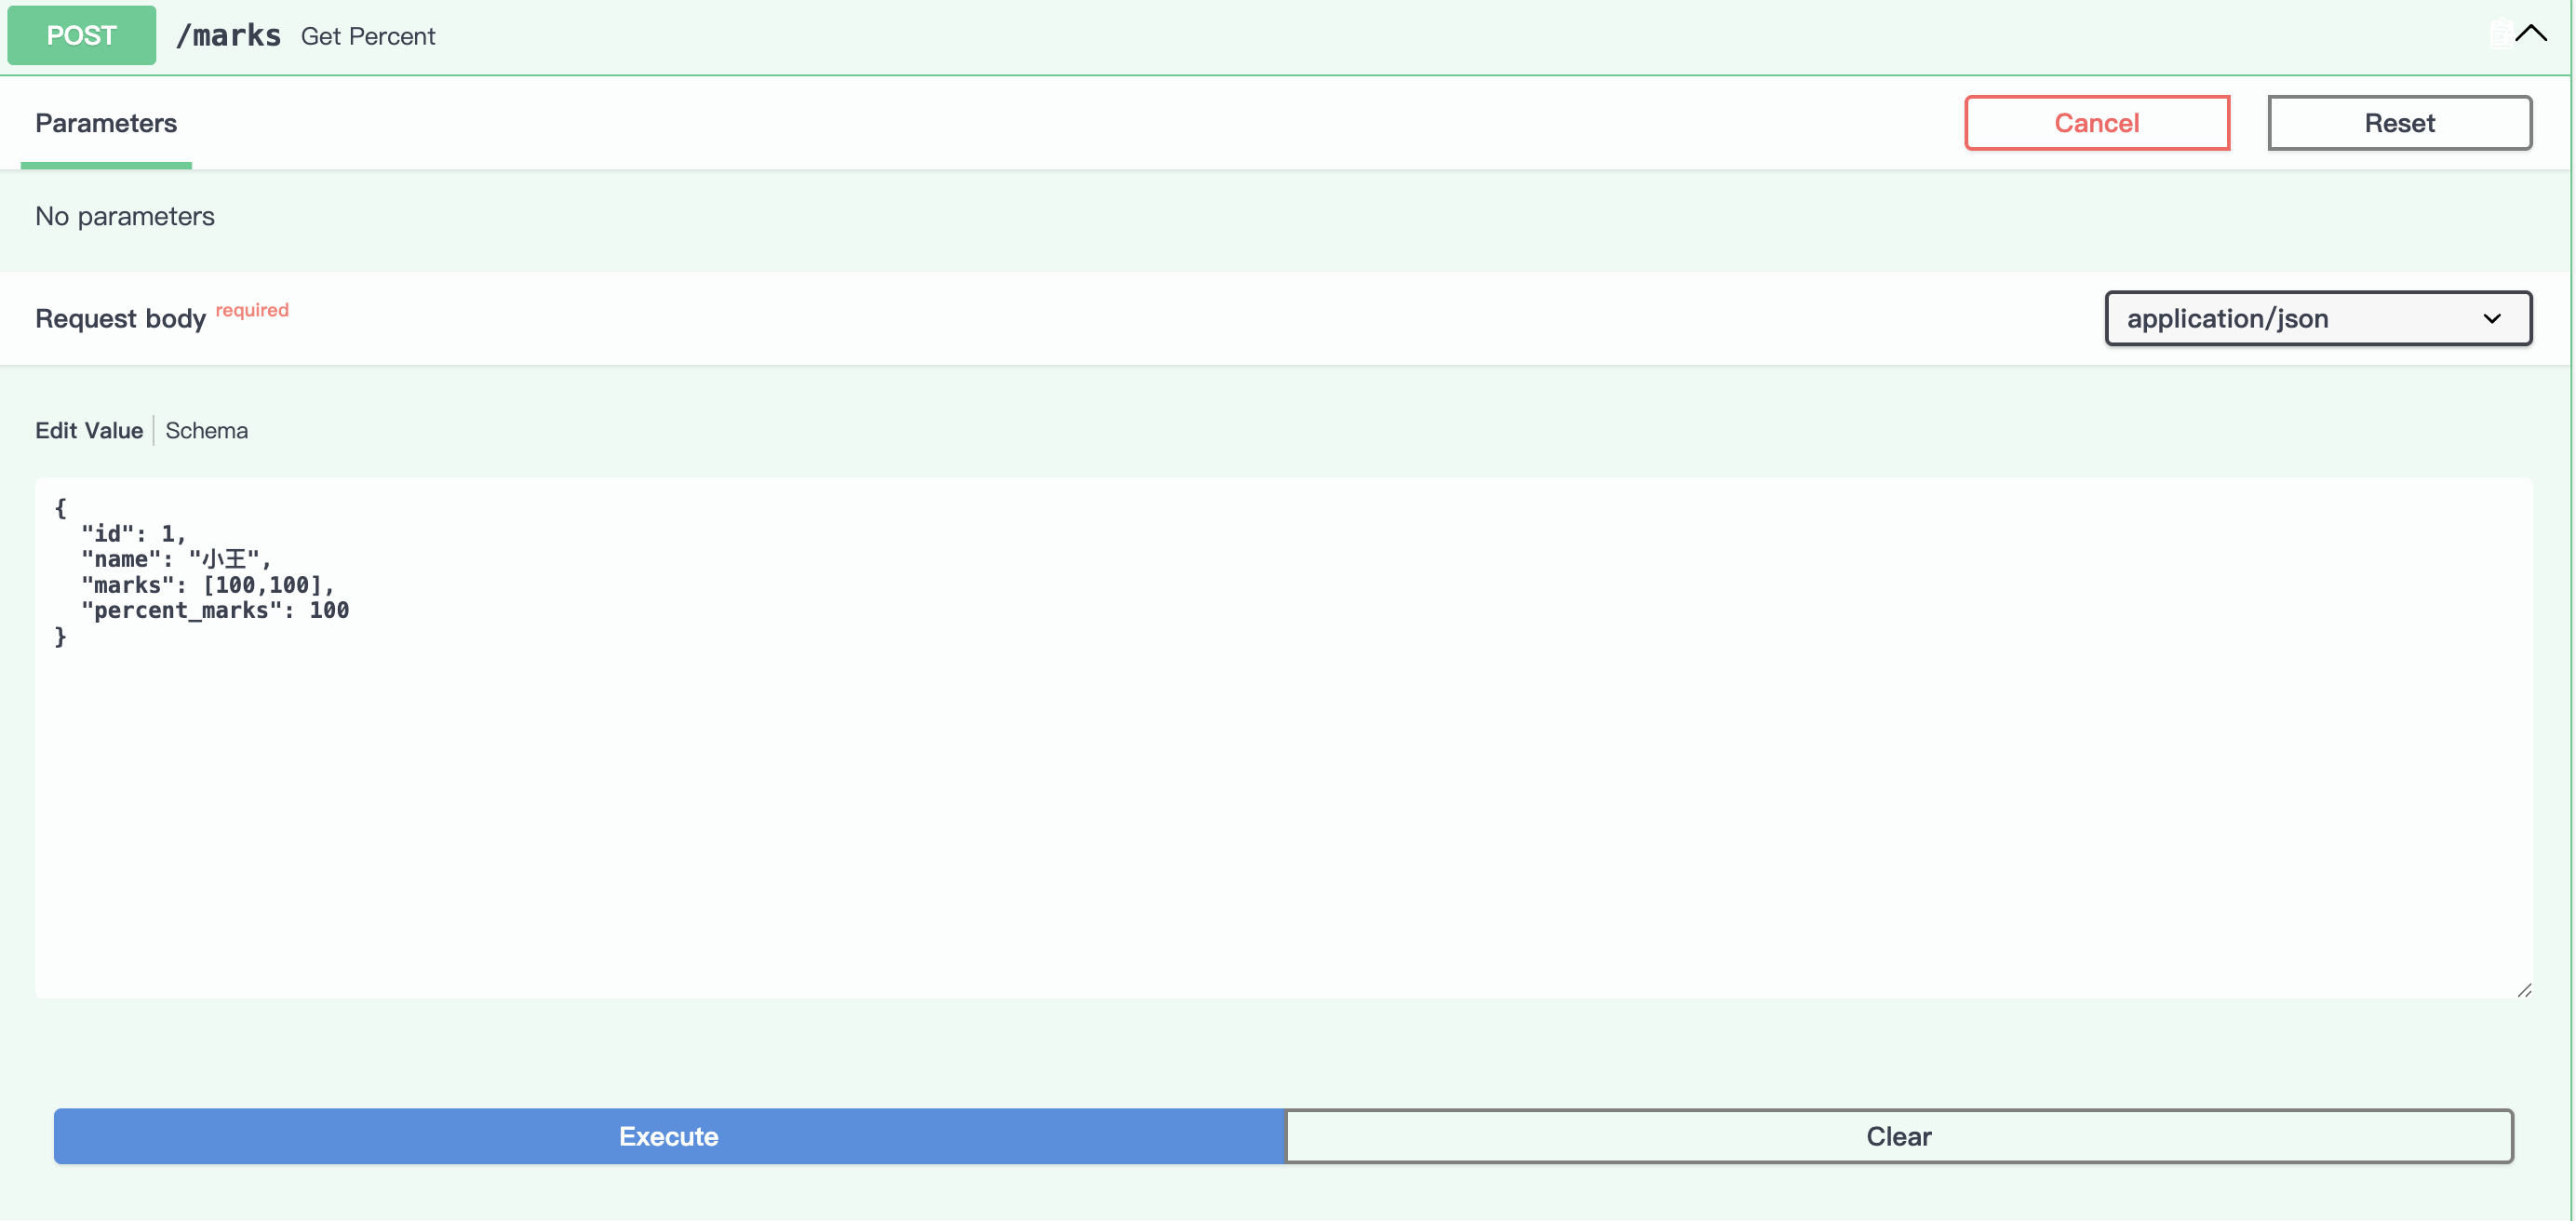
如果我们查看 Swagger 文档,它会显示"/marks"路由获取 student 学生类的对象作为请求主体。 用适当的值填充属性并执行 get_percent() 函数。
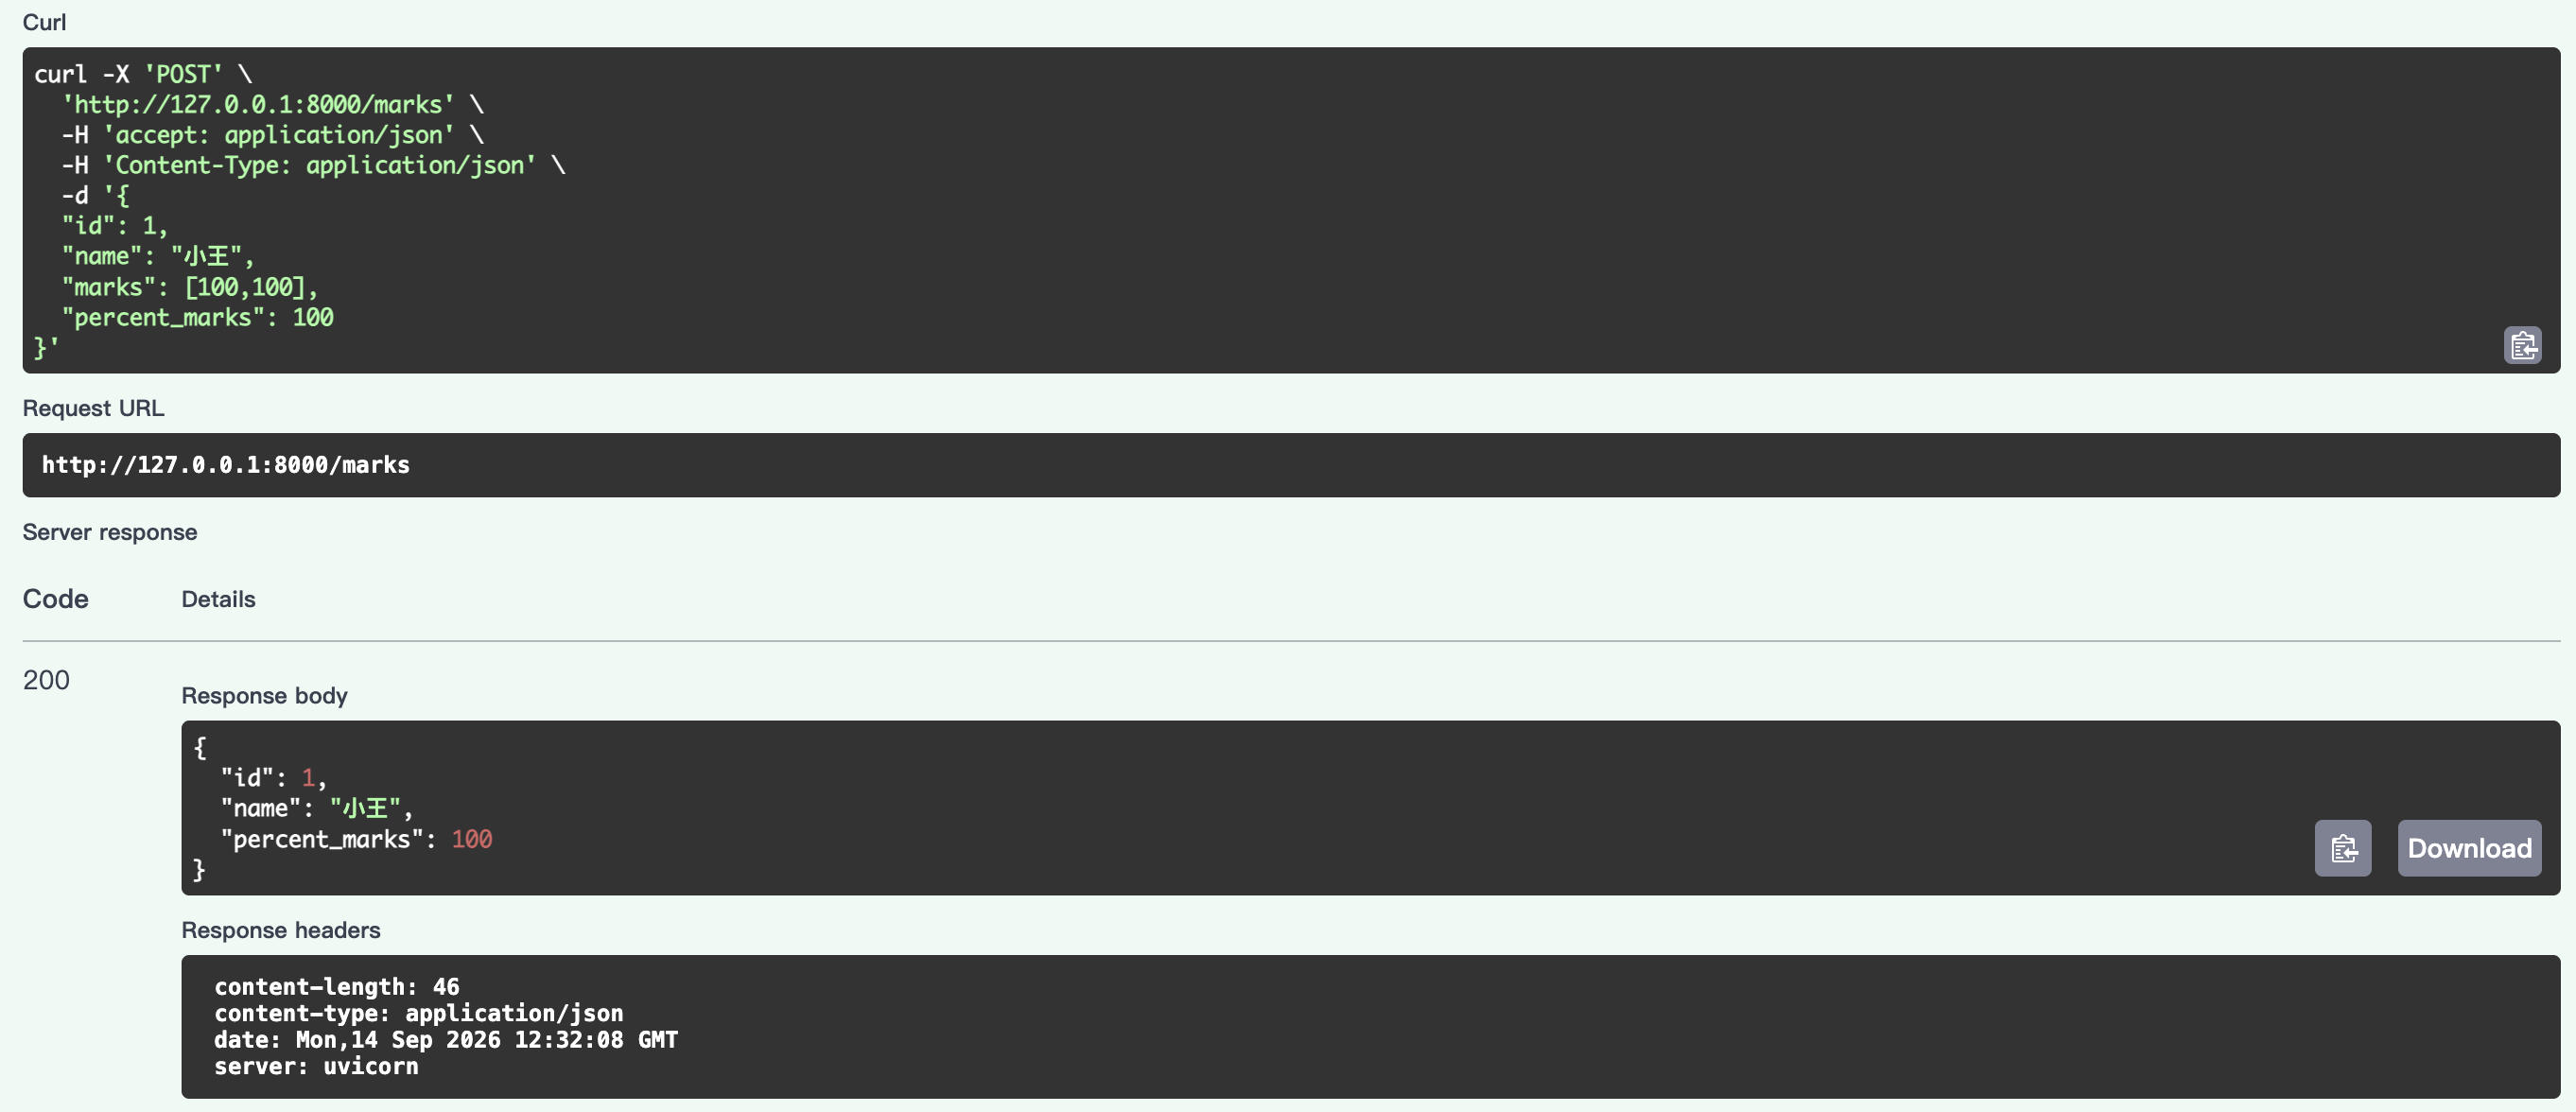
服务器响应被转换为 percent 类,因为它已用作 response_model。
StreamingResponse——流式响应
StreamingResponse 是 FastAPI/Starlette 提供的“流式响应容器”。
普通接口通常是这样:
客户端请求 -> 服务端算完 -> 一次性返回 JSON -> 连接结束它的特点是:先算完,再返回,客户端要等整个结果生成完。
而 StreamingResponse 是:
客户端请求 -> 服务端边生成边发送 -> 客户端边接收边渲染 -> 最后结束它接收一个:
- 同步迭代器
- 异步生成器
- 文件对象
- 类似文件的对象
然后把这些内容分块发送给客户端。
示例
from fastapi import FastAPI, HTTPException
from fastapi.responses import StreamingResponse
import os
import time
import asyncio
from typing import Iterator, AsyncIterator

app = FastAPI()

# ============================================================
# 1. 同步生成器版本
# ============================================================
# 关键理解:这不是一个"函数",而是一个"生成器工厂"——
# 调用 sync_generator() 时函数体一行都不执行,
# 只有 StreamingResponse 开始迭代它(每次要下一个值),
# 代码才推进到下一个 yield,产出一块数据。
# 因此实现了"算一块 → 发一块 → 再算下一块"的节奏。
def sync_generator() -> Iterator[bytes]:
    """每 1 秒产出一个 chunk,模拟服务端边算边发"""
    for i in range(1, 6):
        chunk = f"chunk {i}: hello streaming\n"
        # StreamingResponse 推荐产出 bytes:
        # 网络传输的本质就是字节流,str 还需编码,bytes 是最贴近传输层的格式
        yield chunk.encode("utf-8")
        # time.sleep 在这里是安全的,原因见下面路由函数的注释
        time.sleep(1)  # 模拟耗时任务(数据库查询/LLM 生成等)

# 普通 def(没有 async):FastAPI 会把整个路由函数 + 生成器迭代
# 丢进线程池(anyio 的 threadpool)执行。
# 所以 time.sleep 阻塞的只是"线程池里的某一个工作线程",
# 事件循环线程依然空闲,能继续处理其他请求 —— 服务不会卡死。
# 代价:线程池默认只有 40 个线程,同步路由高并发下会排队。
@app.get("/stream/sync")
def stream_sync():
    return StreamingResponse(
        sync_generator(),                      # 传入生成器,FastAPI 负责逐块迭代发送
        media_type="text/plain; charset=utf-8",  # 纯文本;charset 防止中文乱码
        # 禁缓存:防止浏览器/代理把流攒起来或缓存,保证客户端实时收到每一块
        headers={"Cache-Control": "no-cache"},
    )

# ============================================================
# 2. 异步生成器版本
# ============================================================
# async def + yield 组合 = 异步生成器(AsyncIterator)。
# 它直接在事件循环线程上执行,没有线程池开销,
# 高并发流式场景(如 LLM 逐字输出)首选这种写法。
async def async_generator() -> AsyncIterator[bytes]:
    for i in range(1, 6):
        chunk = f"async chunk {i}: hello streaming\n"
        yield chunk.encode("utf-8")
        # 铁律:async 函数里等待必须用 await asyncio.sleep,
        # 用 time.sleep 会堵死事件循环 —— 整个服务的所有请求全部卡住
        await asyncio.sleep(1)

@app.get("/stream/async")
async def stream_async():
    return StreamingResponse(
        async_generator(),
        media_type="text/plain; charset=utf-8",# 纯文本;charset 防止中文乱码
        headers={"Cache-Control": "no-cache"},# 禁缓存:防止浏览器/代理把流攒起来或缓存,保证客户端实时收到每一块
    )

# ============================================================
# 3. 大文件流式下载
# ============================================================
# 为什么不 file.read() 一次读完?
#   read() 全读:1GB 文件 → 内存瞬间涨 1GB,几个并发请求就把服务打爆
#   分块 read:  无论文件多大,内存里永远只有 64KB —— 内存占用恒定
def file_iterator(path: str, chunk_size: int = 1024 * 64) -> Iterator[bytes]:
    """每次读 64KB 就 yield 一次,读多少发多少"""
    with open(path, "rb") as f:
        while True:
            data = f.read(chunk_size)  # 最多读 64KB;文件不足时返回剩余全部
            if not data:               # 读到空 = 文件结束
                break
            yield data                 # 这 64KB 立刻发出去,再回来读下一块

@app.get("/stream/file")
def stream_file():
    file_path = "./bigfile.txt"
    # 防御:文件不存在时 open() 会抛 FileNotFoundError → 用户看到 500
    # 提前检查并返回 404,语义更准确(404=资源不存在,500=服务器内部错误)
    if not os.path.exists(file_path):
        raise HTTPException(404, "文件不存在,先创建 bigfile.txt")
    return StreamingResponse(
        file_iterator(file_path),
        media_type="application/octet-stream",  # 通用二进制流,浏览器不会尝试打开而是下载
        # Content-Disposition: attachment 触发浏览器"另存为"弹窗
        # filename= 指定保存时的默认文件名
        headers={"Content-Disposition": 'attachment; filename="bigfile.txt"'},
    )
核心功能
| 功能 | 说明 |
|---|---|
| 分块传输 | 不一次性加载全部内容,边生成边发送 |
| 低首字节延迟 | 客户端更快看到第一部分内容 |
| 省内存 | 适合大文件、大日志、长文本 |
| 支持长连接 | 可以持续发送很久 |
| 自定义 media_type | 如 text/event-stream、application/octet-stream |
| 自定义 headers | 如禁用缓存、禁用 Nginx 缓冲 |
| 支持异步生成器 | 很适合 LLM 异步流式调用 |
SSE(Server-Sent Events)服务发送事件
它是一种基于 HTTP 的单向推送协议:
服务器 -> 客户端和普通 HTTP 的区别
| 模式 | 过程 | 例子 |
|---|---|---|
| 普通 HTTP(一问一答) | 客户端请求 → 服务器回一次 → 连接断了 | 你查一次天气,服务器只给你当次结果 |
| SSE(持续推送) | 客户端请求一次 → 服务器 不断 往里发数据 → 客户端被动收 | 大模型逐字输出、股票实时行情、AI Agent 执行日志 |
TIP
所以 SSE 适合"服务器不停推、客户端不用说话"的场景 —— LLM 流式输出就是典型。
SSE 的响应头
Content-Type: text/event-stream
Cache-Control: no-cache
SSE 的数据格式
event: token
data: {"content":"你"}

event: token
data: {"content":"好"}

event: done
data: [DONE]
规则:
event:表示事件类型,比如token、tool_call、errordata:表示数据内容,通常是 JSON 字符串- 一个空行表示一个事件结束
StreamingResponse+SSE
AI Agent 里最常见的组合是:用 StreamingResponse 承载 SSE,把 LLM token、工具调用、执行进度实时推给前端。
组合起来有什么能力
当 StreamingResponse + SSE 组合后,你得到的是:
一个基于 HTTP 的长连接
服务器可以持续发送多个事件
每个事件有类型和数据
客户端可以按事件类型实时处理
典型事件流:
event: meta
data: {"request_id":"abc"}

event: token
data: {"content":"你"}

event: token
data: {"content":"好"}

event: tool_call
data: {"name":"search","args":{"q":"FastAPI"}}

event: tool_result
data: {"result":"..."}

event: done
data: {"finish_reason":"stop"}
前端可以这样处理:
- 收到
token:追加到聊天窗口 - 收到
tool_call:显示“正在调用搜索工具” - 收到
tool_result:显示工具结果 - 收到
error:显示错误 - 收到
done:结束 loading
这就是 AI Agent 流式交互的核心。
示例
import asyncio
import json
import uuid

from fastapi import FastAPI, Request
from fastapi.responses import StreamingResponse, HTMLResponse

app = FastAPI()

def sse_event(event: str, data) -> str:
    """把数据格式化成 SSE 事件"""
    if not isinstance(data, str):# 如果不是字符串,就转换成 JSON 字符串
        data = json.dumps(data, ensure_ascii=False)
    return f"event: {event}\ndata: {data}\n\n"

async def fake_agent_stream(prompt: str, request: Request):
    """
    模拟一个 AI Agent 的流式执行过程:
    meta -> tool_call -> tool_result -> token -> done
    """
    request_id = str(uuid.uuid4())# 生成一个唯一的请求 ID

    # 1. 发送 meta 事件
    yield sse_event("meta", {"request_id": request_id, "prompt": prompt})
    await asyncio.sleep(0.3)

    # 2. 模拟工具调用
    yield sse_event("tool_call", {
        "id": "call_1",
        "name": "search",
        "args": {"q": prompt},
    })
    await asyncio.sleep(0.8)

    # 3. 模拟工具返回
    yield sse_event("tool_result", {
        "id": "call_1",
        "result": f"关于「{prompt}」的搜索结果:FastAPI 是一个现代、快速的 Python Web 框架。",
    })
    await asyncio.sleep(0.3)

    # 4. 模拟 LLM 逐 token 输出
    answer = f"这是针对「{prompt}」的流式回答,逐字输出,模拟大模型打字机效果。"
    for ch in answer:
        # 客户端断开时及时停止,避免继续消耗资源
        if await request.is_disconnected():
            print(f"[{request_id}] 客户端已断开,停止生成")
            return
        yield sse_event("token", {"content": ch})
        await asyncio.sleep(0.05)

    # 5. 发送结束事件
    yield sse_event("done", {"finish_reason": "stop"})

@app.post("/chat/stream")
async def chat_stream_post(request: Request):
    """POST 方式,适合前端携带 JSON body"""
    body = await request.json()
    prompt = body.get("prompt", "")

    return StreamingResponse(
        fake_agent_stream(prompt, request),
        media_type="text/event-stream",# 告诉浏览器:"这不是普通响应,是 SSE 流",浏览器就会一直开着连接等服务器推。
        headers={
            "Cache-Control": "no-cache", # 禁缓存:防止浏览器/代理把流攒起来或缓存,保证客户端实时收到每一块
            "Connection": "keep-alive", # 保持连接:避免每次请求都建立新连接,提高效率
            "X-Accel-Buffering": "no",  # 关键:禁止 Nginx 缓冲
        },
    )

@app.get("/chat/stream")
async def chat_stream_get(prompt: str, request: Request):
    """GET 方式,方便用 EventSource 或浏览器直接测试"""
    return StreamingResponse(
        fake_agent_stream(prompt, request),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no",
        },
    )

@app.get("/", response_class=HTMLResponse)
async def index():
    """一个简单的前端页面,用 fetch 消费 SSE"""
    return """
<!DOCTYPE html>
<html>
<head>
    <meta charset="utf-8">
    <title>StreamingResponse + SSE 示例</title>
    <style>
        body { font-family: system-ui, sans-serif; max-width: 720px; margin: 40px auto; }
        input { width: 70%; padding: 8px; }
        button { padding: 8px 16px; }
        pre { background: #f5f5f5; padding: 16px; white-space: pre-wrap; min-height: 200px; }
    </style>
</head>
<body>
    <h1>AI Agent 流式输出测试</h1>
    <input id="prompt" value="你好,介绍一下 FastAPI" />
    <button onclick="start()">发送</button>
    <pre id="output"></pre>

    <script>
        async function start() {
            const prompt = document.getElementById('prompt').value;
            const output = document.getElementById('output');
            output.textContent = '';

            const res = await fetch('/chat/stream', {
                method: 'POST',
                headers: { 'Content-Type': 'application/json' },
                body: JSON.stringify({ prompt })
            });

            const reader = res.body.getReader();
            const decoder = new TextDecoder();
            let buffer = '';

            while (true) {
                const { value, done } = await reader.read();
                if (done) break;

                buffer += decoder.decode(value, { stream: true });
                const parts = buffer.split('\\n\\n');
                buffer = parts.pop() || '';

                for (const part of parts) {
                    const lines = part.split('\\n');
                    let event = 'message';
                    let data = '';

                    for (const line of lines) {
                        if (line.startsWith('event:')) event = line.slice(6).trim();
                        if (line.startsWith('data:')) data += line.slice(5).trim();
                    }

                    if (!data) continue;
                    const payload = JSON.parse(data);

                    if (event === 'token') {
                        output.textContent += payload.content;
                    } else if (event === 'tool_call') {
                        output.textContent += `\\n[调用工具: ${payload.name}]\\n`;
                    } else if (event === 'tool_result') {
                        output.textContent += `[工具结果: ${payload.result}]\\n`;
                    } else if (event === 'done') {
                        output.textContent += '\\n[完成]';
                    } else if (event === 'error') {
                        output.textContent += `\\n[错误: ${payload.message}]`;
                    }
                }
            }
        }
    </script>
</body>
</html>
    """
JSONResponse
FastAPI 的响应类,用来手动返回 JSON。
普通写法:
python
return {"id": 1, "name": "Tom"}FastAPI 会自动转成 JSON,状态码默认 200。
TIP
但如果你要:
- 自定义状态码
- 自定义 headers
- 统一错误结构
- 加
X-Request-ID、Retry-After - 在流式接口前返回错误
就用 JSONResponse。
示例
from fastapi import FastAPI, status
from fastapi.responses import JSONResponse

app = FastAPI()

@app.get("/users/{user_id}")
async def get_user(user_id: int):
    if user_id != 1:
        return JSONResponse(
            status_code=status.HTTP_404_NOT_FOUND,
            content={
                "code": "USER_NOT_FOUND",
                "message": "用户不存在",
            },
            headers={"X-Request-ID": "req-123"},
        )

    return {"id": 1, "name": "Tom"}
和普通 return dict 的区别
| 对比 | return dict | JSONResponse |
|---|---|---|
| 状态码 | 用装饰器 status_code | 自己传 status_code |
| headers | 不方便 | 可以自定义 |
| 错误结构 | 不够灵活 | 很灵活 |
| response_model | 生效 | 通常不生效 |
| 使用频率 | 最高 | 高频,错误/特殊响应时用 |
HTMLResponse
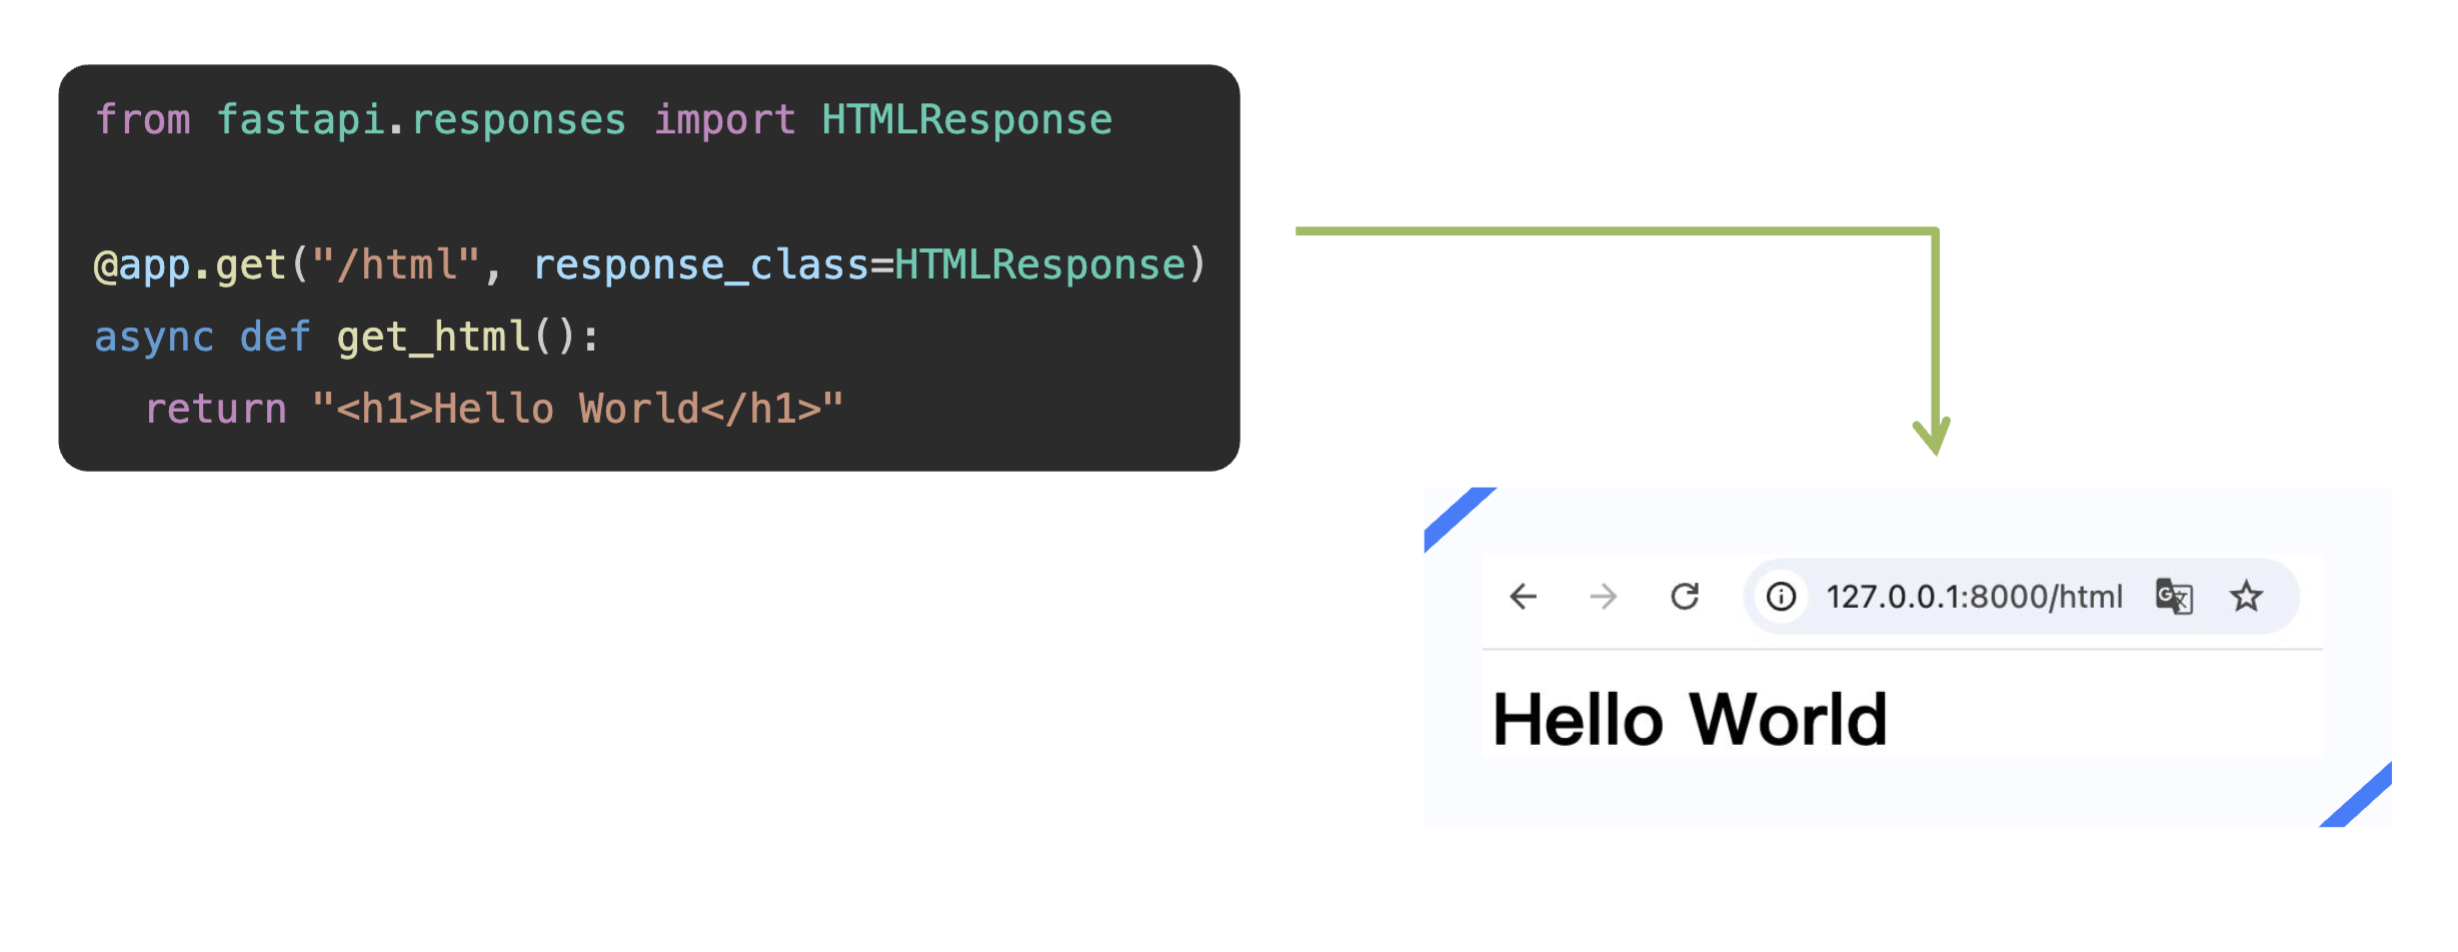
设置响应类为 HTMLResponse,当前接口即可返回 HTML 内容
FileResponse
FileResponse是 FastAPI 提供的专门用于高效返回文件内容(如图片、PDF、Excel、音视频等)的响应类。它能够智能处理文件路径、媒体类型推断、范围请求和缓存头部,是服务静态文件的推荐方式。
status_code——状态码
在 FastAPI 里,status_code 用来指定接口成功时返回的 HTTP 状态码。
写法
最常用:写在路径装饰器里
from fastapi import FastAPI, status

app = FastAPI()

@app.post("/items/", status_code=status.HTTP_201_CREATED)
async def create_item():
    return {"name": "item"}
也可以直接写数字:
@app.post("/items/", status_code=201)
async def create_item():
    return {"name": "item"}
推荐用 fastapi.status 里的常量,更语义化:
status.HTTP_200_OK
status.HTTP_201_CREATED
status.HTTP_204_NO_CONTENT
status.HTTP_404_NOT_FOUND
动态设置:注入 Response
如果状态码要根据逻辑变化,可以注入 Response:
from fastapi import Response, status

@app.post("/items/")
async def create_item(response: Response):
    response.status_code = status.HTTP_201_CREATED
    return {"name": "item"}
WARNING
注意:注入的 Response 里设置的 status_code 会覆盖装饰器里的设置。
直接返回 Response 对象
from fastapi.responses import JSONResponse

@app.post("/items/")
async def create_item():
    return JSONResponse(
        status_code=201,
        content={"name": "item"}
    )
这种方式完全由你控制状态码。
错误状态码:用 HTTPException
错误不要靠 status_code 装饰器,而是抛异常:
from fastapi import HTTPException, status

@app.get("/items/{item_id}")
async def read_item(item_id: int):
    if item_id != 1:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="Item not found"
        )
    return {"item_id": item_id}
FastAPI 会自动返回对应状态码和错误信息。
优先级
如果同时存在:
- 直接返回
Response对象 → 以它的status_code为准 - 注入
Response并设置status_code→ 覆盖装饰器 - 装饰器
status_code→ 作为成功响应默认值 - 都没写 → 默认
200
常见状态码
| 状态码 | 含义 | 场景 |
|---|---|---|
| 200 | OK | 默认成功 |
| 201 | Created | 创建资源成功 |
| 204 | No Content | 成功但不返回内容 |
| 400 | Bad Request | 请求参数错误 |
| 401 | Unauthorized | 未认证 |
| 403 | Forbidden | 无权限 |
| 404 | Not Found | 资源不存在 |
| 422 | Unprocessable Entity | FastAPI 校验失败默认 |
| 500 | Internal Server Error | 服务器错误 |
注意
WARNING
status_code会写进 OpenAPI 文档,作为成功响应的状态码。204不能有响应体,不要返回内容。- 装饰器里的
status_code只影响成功响应,错误响应要用HTTPException。 APIRouter的每个路由也可以单独设置status_code。
FastAPI - 依赖
在 FastAPI 中,“依赖”指的是依赖注入系统中的依赖项,不是 requirements.txt 里的第三方包依赖。
INFO
通俗说:某个接口在处理请求前,需要先准备一些东西,比如数据库连接、当前用户、权限校验、公共查询参数等。这些“需要先准备并传入的东西”就是依赖。FastAPI 通过 Depends 帮你自动调用它们,并把结果注入到路径操作函数中。
Depends()
Depends() 是 FastAPI 依赖注入系统的核心,它让路径操作函数(或其它依赖)声明自己需要什么,由 FastAPI 自动创建并注入
基本用法
from fastapi import FastAPI, Depends

app = FastAPI()

# 创建依赖项
def common_params(q: str | None = None, skip: int = 0, limit: int = 10):
    return {"q": q, "skip": skip, "limit": limit}

@app.get("/items/")
async def read_items(params: dict = Depends(common_params)):#声明依赖项
    return params
推荐写法(Annotated)
from typing import Annotated
from fastapi import Depends

app = FastAPI()

# 创建依赖项
def common_params(q: str | None = None, skip: int = 0, limit: int = 10):
    return {"q": q, "skip": skip, "limit": limit}


@app.get("/items/")
async def read_items(params: Annotated[dict, Depends(common_params)]):
    return params
FastAPI 会:
- 看到
Depends(common_params) - 调用
common_params - 自动解析它的参数
q、skip、limit(从查询参数) - 把返回值注入到
params
请求 /items/?q=foo&skip=5 得到:
{"q": "foo", "skip": 5, "limit": 10}类依赖
使用类而不是函数来管理依赖项。类的 __init__ 参数会被解析。
from fastapi import FastAPI, Depends, HTTPException
from typing import Annotated

# 初始化 FastAPI 应用
app = FastAPI()

# 创建一个类依赖,用于存储用户信息
class Request:
    def __init__(self, name: str, age: int, email: str):
        self.name = name
        self.age = age
        self.email = email

# 校验依赖:未成年(age < 18)不符合条件,拦截并返回 400
async def validate(request: Annotated[Request, Depends(Request)]):
    if request.age < 18:
        raise HTTPException(status_code=400, detail="You are not eligible")
    return request          # ← 校验通过,把对象往下传

@app.get("/user")
async def get_user(request: Annotated[Request, Depends(validate)]):  # ← 直接依赖 validate
    return request
嵌套依赖
嵌套依赖就是:一个依赖本身又依赖另一个依赖,层层套起来。FastAPI 会自动帮你把整条链解开,按顺序调用,再把结果传给需要的地方。
路由函数依赖 A,A 又依赖 B,B 又依赖 C……
FastAPI 会先调用 C,再调用 B,再调用 A,最后调用路由函数。
像剥洋葱:从最里面一层开始,剥完一层再往外一层。
示例
from typing import Annotated
from fastapi import Depends, FastAPI, Header, HTTPException

app = FastAPI()

# 第 1 层:校验 token
def get_token(x_token: Annotated[str, Header()]):
    if x_token != "secret":
        raise HTTPException(status_code=400, detail="token 无效")
    return x_token

# 第 2 层:根据 token 获取用户,依赖 get_token
def get_user(token: Annotated[str, Depends(get_token)]):
    return {"name": "alice", "token": token}

# 第 3 层:路由函数依赖 get_user
@app.get("/me")
def read_me(user: Annotated[dict, Depends(get_user)]):
    return user
请求 /me 时,FastAPI 的执行顺序是:
- 发现
read_me依赖get_user - 发现
get_user依赖get_token - 先执行
get_token,拿到 token - 把 token 传给
get_user,拿到 user - 把 user 传给
read_me,返回结果
这就是嵌套依赖。
核心特点
自动递归解析
不用手动调用 get_token() 或 get_user(),FastAPI 会根据 Depends 自动构建依赖树。
先子后父
越底层的依赖越先执行,结果逐层向上传递。
同一请求默认只执行一次
如果多个地方都依赖 get_token,默认只调用一次,结果复用。
这叫依赖缓存,想每次重新执行可以写:
Depends(get_token, use_cache=False)可以嵌套多层
依赖 A 依赖 B,B 依赖 C,C 依赖 D……都行。但别太深,否则可读性会变差。
总结
嵌套依赖就是依赖里再写依赖。
FastAPI 会自动从最底层开始调用,把结果一层层往上传,最后注入到路由函数。
你只需要声明“谁依赖谁”,剩下的交给 FastAPI。
yield 依赖(生成器依赖)
FastAPI 中的 yield 依赖 是指用生成器函数(同步或异步)作为依赖,通过 yield 提供一个值,并在请求结束后执行清理逻辑。它是管理请求级资源(如数据库会话、文件、连接、锁、事务)的推荐方式。
基本语法
同步生成器依赖
from fastapi import Depends, FastAPI
from typing import Annotated

app = FastAPI()

def get_db():
    db = SessionLocal()
    try:
        yield db          # 把 db 注入给路径函数
    finally:
        db.close()        # 请求结束后清理

@app.get("/users/")
def read_users(db: Annotated[Session, Depends(get_db)]):
    return db.query(User).all()
异步生成器依赖
async def get_db():
    db = AsyncSession()
    try:
        yield db
    finally:
        await db.close()
FastAPI 同时支持 def 和 async def 的生成器依赖。
def生成器会在线程池中运行,适合同步阻塞库。async def生成器在事件循环中运行,适合异步库。
执行时机与生命周期
yield 依赖把依赖的执行分成两个阶段:
- 进入阶段:FastAPI 调用依赖函数,执行到
yield,暂停,把yield的值作为依赖结果注入。 - 退出阶段:请求处理完成、响应发送后,FastAPI 恢复生成器,执行
yield之后的代码。
官方文档描述:yield 之后的代码会在响应发送之后执行。
因此,如果清理代码很慢,客户端可能已经收到响应,但请求生命周期尚未完全结束。
依赖树中的执行顺序
如果依赖有嵌套关系,进入和退出遵循“后进先出”:
python
def dep_a():
    print("A 进入")
    yield "A"
    print("A 退出")

def dep_b(a = Depends(dep_a)):
    print("B 进入")
    yield "B"
    print("B 退出")

@app.get("/")
def route(b = Depends(dep_b)):
    print("路径函数执行")
    return {}
A 进入
B 进入
路径函数执行
B 退出
A 退出即:子依赖先进入,父依赖后进入;退出时父依赖先退出,子依赖后退出。
异常处理
如果路径函数或后续依赖抛出异常,FastAPI 会把异常抛入生成器的 yield 处。你可以在依赖中捕获异常,但通常必须重新抛出,否则会抑制异常,导致 FastAPI 无法正确处理。
def get_db():
    db = SessionLocal()
    try:
        yield db
    except Exception:
        db.rollback()   # 发生异常时回滚
        raise           # 必须重新抛出
    finally:
        db.close()      # 无论是否异常都会执行
关键点:
WARNING
finally中的清理代码总会执行。- 如果捕获异常后不重新抛出,异常会被“吞掉”,路径函数不会返回错误响应。
- 清理代码本身不应抛出异常,因为此时响应可能已发送,无法再改变响应状态。
依赖缓存 use_cache(了解)
同一个请求中,同一个 yield 依赖默认只进入一次、退出一次(use_cache=True)。
如果设置 use_cache=False,每次依赖都会重新进入和退出:
Depends(get_db, use_cache=False)这适用于需要每次创建独立资源的场景,但通常不推荐,因为会频繁创建/销毁连接
总结
yield 依赖是 FastAPI 中实现“进入 → 使用 → 清理”生命周期的核心机制。它通过生成器让依赖在请求处理前准备资源,在请求结束后自动释放资源,非常适合数据库会话、事务、文件、锁等场景。正确使用 try/finally 和异常重新抛出,可以确保资源安全释放且异常不被吞掉。